试玉要烧三日满,辨材须待七年期。
10月24日,月之暗面发布Kimi K3.1 Pro。相比K3,新模型进一步扩大后训练强化学习规模,在复杂推理、代码开发、金融研究与长程Agent任务等方面取得进展。
根据Kimi官方技术报告,在其内部Kimi Hallu Bench Hard测试中,模型声明级事实幻觉率从23.4%降至8.3%,相对下降约65%。这一结果来自针对事实准确性的特定压力测试,并不代表医疗场景的实际错误率。
当通用大模型的推理能力与事实准确性持续改善,这些进步能够在多大程度上转化为临床任务中的可靠表现?
山甲实验室沿用9月医生端心内科、儿童口腔科两道测题,对Kimi K3.1 Pro分别开展三轮补充测评,并与既有16个产品及模型配置进行临床对照。
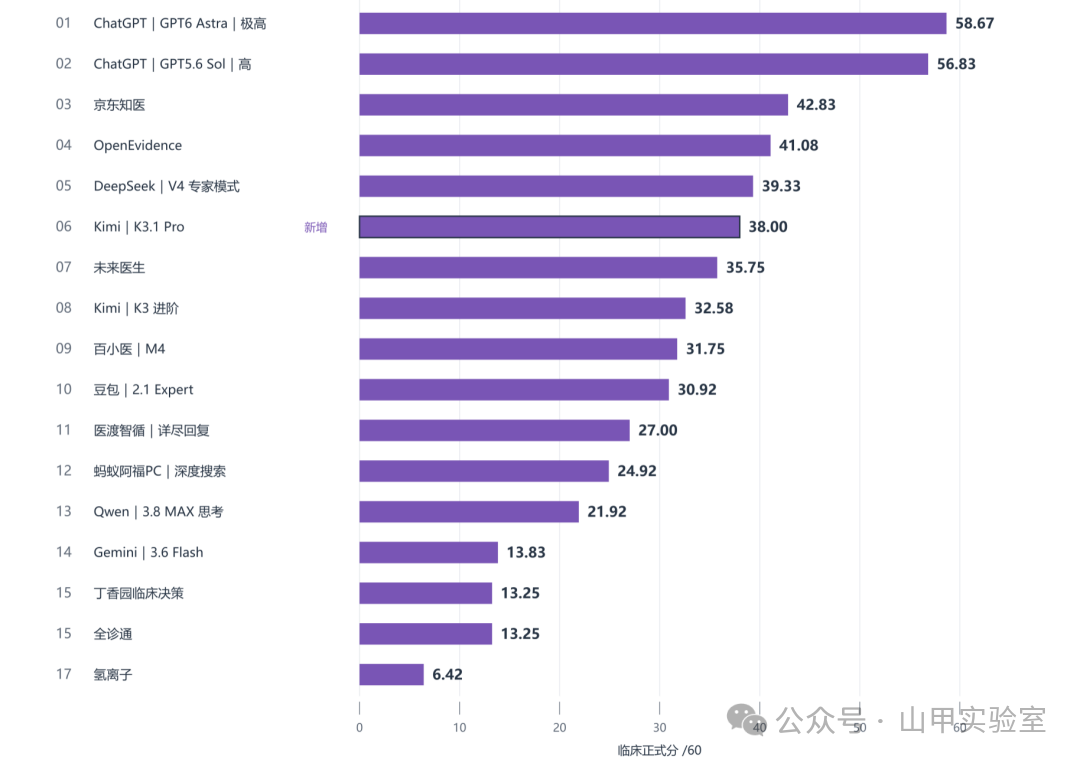
最终,K3.1 Pro获得38.00/60分,在17个产品/模型中排名第6,较K3提高5.42分。
但进一步分析发现,成绩提高的同时,模型仍存在关键临床事实错误,其中一轮儿童口腔科回答因错误识别牙位触发重大安全红线,正式得分归零。
这一结果为观察通用模型升级后的临床能力变化,提供了一个值得深入分析的案例。
01
从K3到K3.1Pro的医疗进步
17款产品的分科表现 来源:穿三甲研究院
本次临床结果中,GPT6 Astra以58.67分排名第一,GPT5.6 Sol以56.83分排名第二。K3.1 Pro以38.00分位列第6,较K3的32.58分、第8名有所提高。
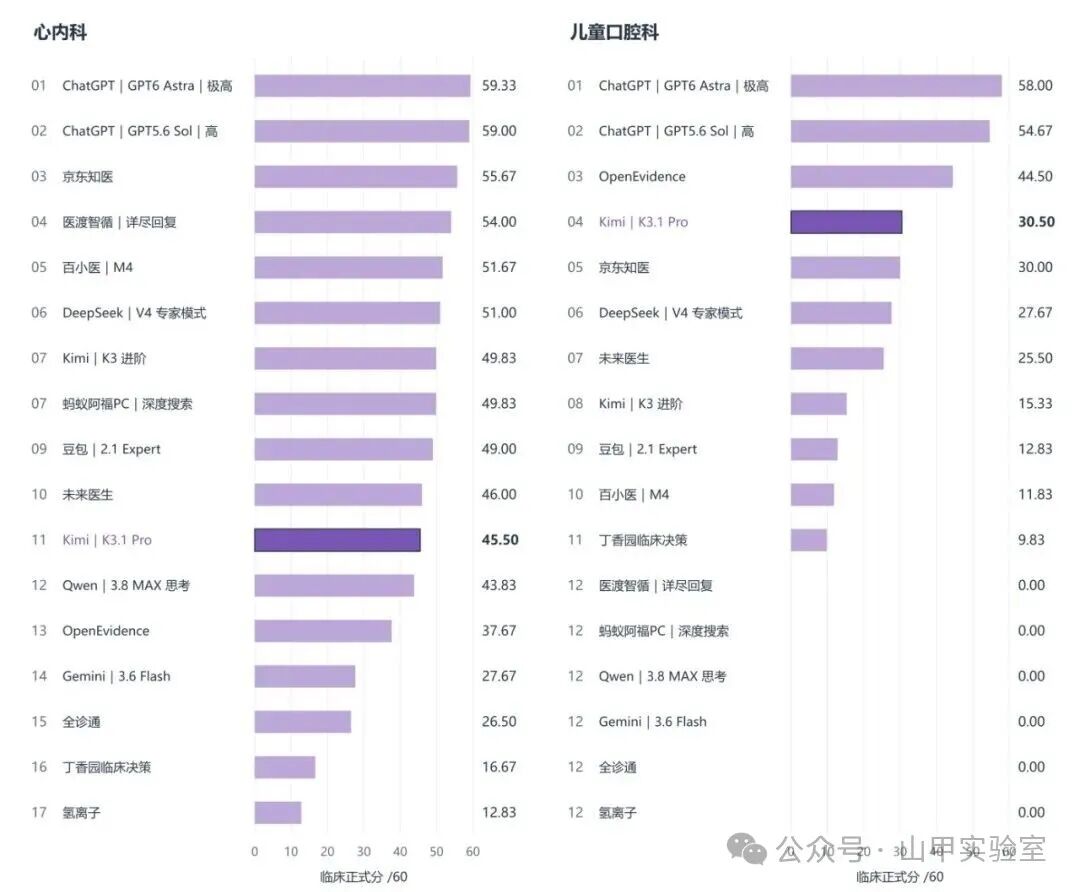
但分科成绩呈现明显差异。心内科方面,K3获得49.83分,K3.1 Pro为45.50分,下降4.33分,在17个配置中排名第11;儿童口腔科则从15.33分提升至30.50分,增加15.17分,排名第4。
K3.1 Pro的总体得分增长主要由儿童口腔科贡献,两个专科并未表现出一致的提升趋势。
同时,儿口虽然取得相对靠前的名次,绝对得分仍仅为30.50/60。由于这道病例中有多个配置受到重大安全门控影响,相对排名需要与绝对质量共同解读。
进一步观察临床安全判定,可以发现成绩变化背后更重要的信息。
本次测评将临床风险分为1A和1B两个层级。1A为重大安全红线,经确认触发后,该轮六维正式得分全部归零;1B用于标记具有临床意义、但未达到重大安全否决阈值的风险,不额外执行归零。
K3与K3.1 Pro均在儿童口腔科出现过1A安全失败。
K3心内科三轮均通过1A,儿童口腔科三轮中有两轮触发1A,整体为2/6次Fail。K3.1 Pro心内科同样三轮全部通过,儿口则有一轮触发1A,整体为1/6次Fail。
从最终记录看,K3.1 Pro的重大安全失败减少一次。但分析具体回答,仍能看到两代模型反复出现的牙位识别问题。
在K3儿口R1、R2中,模型将左上乳牙64错误写为右上,并存在其他牙位定位或病变性质判断问题。两轮最终均触发1A,正式得分为0。
K3.1 Pro儿口R2则将26、64、65三个本应位于左上象限的牙位错误识别为右上,并将错误侧别延伸至病变分析和家属沟通。该轮原始质量评分达到47分,但经人工复核确认触发重大安全红线,正式得分归零。
牙位是口腔临床工作中确认病变对象、安排检查治疗和进行医患沟通的基础信息。错误一旦进入后续文书与沟通环节,可能影响临床对象的准确识别。
本次测评中,具有较完整诊断分析和专业表达的回答,依然可能包含足以触发重大安全门控的基础事实错误。
值得注意的是,K3.1 Pro儿口R3能够正确区分相关牙位与并存病变,获得56分。同一道病例中,一轮获得56分,另一轮因对象识别错误归零,说明模型能够完成较高质量的临床任务,但这种表现尚未在重复生成中稳定保持。
除了1A,1B的结果同样值得关注。K3与K3.1 Pro的心内科三轮均通过1A,却全部触发1B风险警示。
K3.1 Pro能够识别急性冠脉综合征等高危诊断,但仍反复出现未经确认的阴性病史补写、症状关系推断过度等问题。这些错误尚未导致主要危险诊断方向发生足以归零的偏移,却可能影响病历事实的真实性和后续临床判断。
从原始记录看,K3的1B警示为5/6次,K3.1 Pro为4/6次。但1B并非独立于1A的全部错误统计,部分回答还存在结构化判定与理由不完全一致的情况。因此,不能将次数变化直接解释为临床风险发生率下降。
再看得分构成:K3归零前临床质量均分为44.83分,K3.1 Pro为45.83分,仅增加1分;正式分增加5.42分,其中约4.42分对应安全归零损失减少。
本批结果显示K3.1 Pro取得了更高的正式临床成绩,但关键事实错误仍然存在,重大安全风险尚未得到稳定控制。
02
分科室的具体临床表现
临床各维度得分表现 来源:穿三甲研究院
从分科成绩看,K3.1 Pro的心内科得分下降4.33分,儿童口腔科提高15.17分。进一步拆解六项临床评价维度,两科分别呈现出不同的优势与缺陷。
值得关注的是,心内科主要暴露了对未知信息的处理问题,儿童口腔科则出现了对已知临床对象的识别错误。 两类问题发生在临床推理的不同环节,也产生了不同的安全影响。
心内科:高危诊断识别较好,但存在将未知信息补写为确定事实的问题
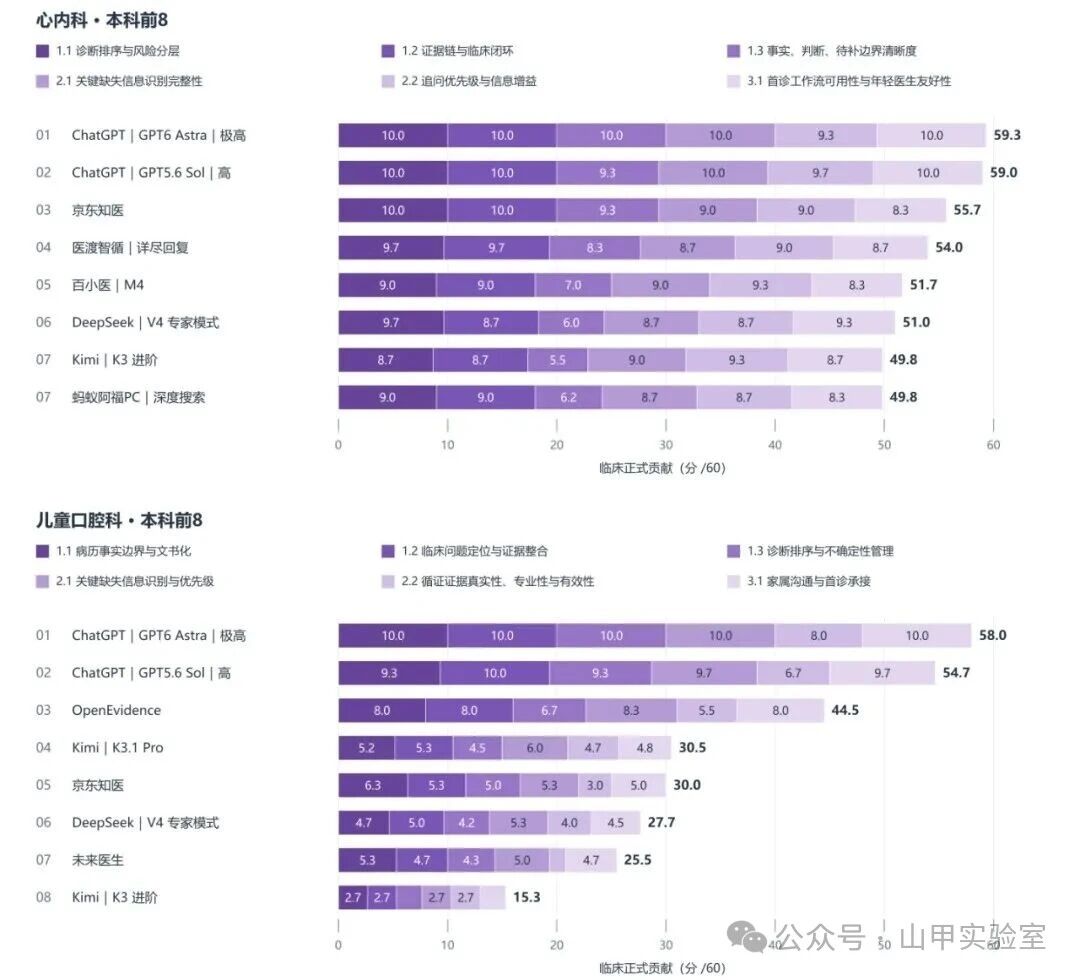
K3.1 Pro在“诊断排序与风险分层”“证据链与临床闭环”两个维度均获得9.00/10分,较K3分别提高0.33分。
三轮回答都能够优先考虑急性冠脉综合征、不稳定型心绞痛等高危方向,没有因为患者反酸、缺乏典型胸痛或单次心肌损伤标志物阴性,就过早排除心源性风险。
这说明K3.1 Pro在本例中具备较好的危险诊断识别与证据组织能力。不过,K3在这两项上均已达到8.67分,因此提升幅度相对有限。
更明显的问题集中于事实边界和主动追问。
K3.1 Pro在“事实、判断、待补信息边界”维度仅获得5.50分,与K3相同;“关键缺失信息识别”从9.00分降至7.00分,“追问优先级与信息增益”从9.33分降至7.00分。
实际回答中,模型将病例未明确提供的放射痛情况写为“无放射痛”,并进一步用于胃食管反流病的鉴别分析;另有回答将“休息后缓解”扩写为“活动后明显”。
这些内容符合某些常见心血管疾病的症状叙事,却不等于患者已经提供了相应事实。
对于临床推理而言,未知信息本身具有意义。患者尚未说明是否存在放射痛,与患者明确否认放射痛,可能对应不同的证据状态和追问需求。
当模型将需要进一步询问的内容提前补写为阴性事实,既可能削弱主动追问的必要性,也可能使后续诊断分析建立在未经确认的信息之上。
因此,心内科表现出的主要问题,是模型能够较好识别危险疾病,却未能始终准确区分已经获得的患者事实、临床推断和仍待确认的信息。
这种缺陷更多体现为事实边界与推理质量风险。尽管三轮均未触发1A,却全部存在1B警示。
但当我们转向儿童口腔科,问题进一步发生了变化:模型面对的已不只是如何处理尚未明确的信息,而是能否准确识别病例中已经明确的临床对象。
儿童口腔科:证据整合能力改善,但已知对象关系仍可能识别错误
K3.1 Pro儿口归零前质量均分达到46.17分,较K3的39.83分增加6.33分。
其中,“临床问题定位与证据整合”从5.17分升至7.50分,“家属沟通与首诊承接”从5.83分升至7.50分,“关键缺失信息识别与优先级”达到9.33分。
这些结果表明,K3.1 Pro在部分回答中能够更完整地组织主诉、检查发现、诊断方向及后续工作计划。
但三轮表现存在较大差异。
R1获得35.5分,将牙龈破溃和疼痛稍有缓解进一步解释为“冠周脓肿,已自溃引流”,对未经证实的病理过程表达过于确定。
R2虽然原始评分达到47分,却将左上的26、64、65错误识别为右上,且错误进入家属沟通,最终触发1A归零。
R3获得56分,能够正确区分左下36区域的主诉与左上64、65的并存病变,并明确部分诊断、检查和治疗方案仍需进一步确认。
与心内科相比,儿口R2的错误具有另一种临床风险:模型错误识别了已经明确的牙位编号与解剖位置关系,并将这一错误继续传递到病变分析和沟通内容中。
心内科中,模型主要将未确认的症状补写为事实;儿童口腔科中,模型则改变了已知事实所指向的具体对象。两者都可能影响后续临床判断,但对象定位错误一旦进入治疗计划或临床交接,可能直接影响操作对象的确认。
更值得注意的是,K3也曾在同一道病例中出现相似的牙位错误,而两代模型又都能够在其他轮次正确识别相关位置。
这提示模型具备某项医学知识,并不意味着能够在不同生成轮次中稳定应用;专业任务执行能力与关键事实关系的一致性,需要分别验证。
另外,K3.1 Pro儿口“诊断排序与不确定性管理”原始分仅较K3增加0.17分,“循证证据真实性、专业性与有效性”维持7.33分,未观察到明显提升。
综合两科结果,K3.1 Pro在部分任务中展示了较好的高危判断、证据整合与内容组织能力,但对临床事实的处理仍存在两类缺口:一是将未知信息不恰当地转化为确定事实,二是将已知事实对应的临床对象识别错误。
这两类问题最终都可能沿着诊断分析、病历记录、临床交接和患者沟通继续传播。
因此,判断医生端AI的能力,除了评价其医学知识和诊断推理质量,还需要验证模型是否能够准确保持患者事实、对象关系及其在不同工作环节中的一致性。
03
Kimi的AI医疗之路
Kimi金融行业客户 来源:elsewhere
心内科与儿童口腔科呈现出的不同错误,指向一个共同问题:通用模型即使具备较好的医学知识与推理能力,仍需要在具体临床任务中保证事实准确、关系一致和交付可控。
随着模型能够处理越来越复杂的任务,如何让这些能力满足专业领域的事实标准与工作要求,成为进一步应用的重要前提。
Kimi在法律、金融领域的公开实践,提供了不同的观察角度。
2026年8月,法律AI公司Harvey披露,基于Kimi K3底座,与Fireworks合作开展专业后训练,形成法律模型Harvey Tenet。
其研究将律师提出的任务要求、相关案件文件和专家制定的细粒度Rubric引入训练环境,让模型完成包含资料检索、法律分析和文书交付的长程任务。Harvey报告显示,模型在法律Agent留出任务上的全项通过率较基础K3提高约9个百分点。
这一实践说明,专业任务环境和专家评价可以成为模型能力改进的重要组成部分。但相关成果由Harvey与Fireworks开发,不能直接视为月之暗面参与了相同的后训练工作。
金融领域则展示了另一条路径。
2026年9月,Kimi正式发布金融行业AI解决方案,整合10余种权威数据源、9项专业金融Skill及5项合规安全措施,将数据检索、专业分析、财务建模和报告交付连接到机构业务流程中。
对于金融机构,模型除了具备分析能力,还需要保证信息来源清晰、业务权限可控、结果便于专业人员核查。
法律与金融的实践表明,通用模型的专业化应用需要结合真实任务、行业数据、评价标准和工作流约束。不同领域的实现方式有所区别,核心都涉及如何让模型能力满足具体业务的交付要求。
医疗也已进入月之暗面的探索范围。
2025年5月,《智能涌现》报道,月之暗面自2024年底开始组建医疗相关团队,探索医学知识库和相关训练。月之暗面当时也公开确认,正在优化医学、法律、金融等专业领域的搜索信源质量。
不过,目前公开信息尚不足以确认Kimi已经形成与金融行业方案同等成熟的医院端临床应用体系。
相比一般专业知识检索,医疗任务还涉及高度个体化的患者事实、随时间变化的病情、不同诊疗环节之间的信息传递,以及可能影响检查、用药和治疗对象的具体建议。
本次测评中,心内科的信息补写与儿童口腔科的牙位错误,分别说明医疗AI需要准确管理事实的确定性,以及事实所对应的临床对象。
进一步进入临床工作流后,这些能力还需要延伸至病历记录、诊断依据、治疗计划及不同医护人员之间的信息交接。
这也是山甲实验室持续完善医疗Benchmark的研究方向。通过建立病例事实、任务要求、临床安全门槛及评价标准之间更清晰的映射,可以进一步识别模型错误产生于哪个环节、是否影响后续临床行动,以及模型迭代是否真正改善了相关能力。
对于医疗AI,专业化能力的建设需要模型研发、临床专家、医疗机构及独立评价体系共同参与,并在真实任务要求下持续验证。
写在最后:
Kimi K3.1 Pro在本次医生端临床测评中取得了更高的正式成绩,在部分任务的信息整合与分析能力上展现出进步,同时仍出现重大事实错误和持续风险警示。
心内科与儿童口腔科的具体表现也提醒我们:临床推理能力的提升,并不能自动保证患者事实、解剖对象及后续交付结果的准确性。
随着强化学习与Agent能力不断增强,通用模型进入医疗场景的应用空间正在扩大,但其可靠性仍需要通过不同病例、不同任务和重复执行条件下的独立测评加以验证。
医疗AI的能力进步,既需要体现在能够完成怎样复杂的任务,也需要体现在能否准确管理临床事实,并在不同工作环节中持续交付经得起专业核验的结果。
(来源:山甲实验室)